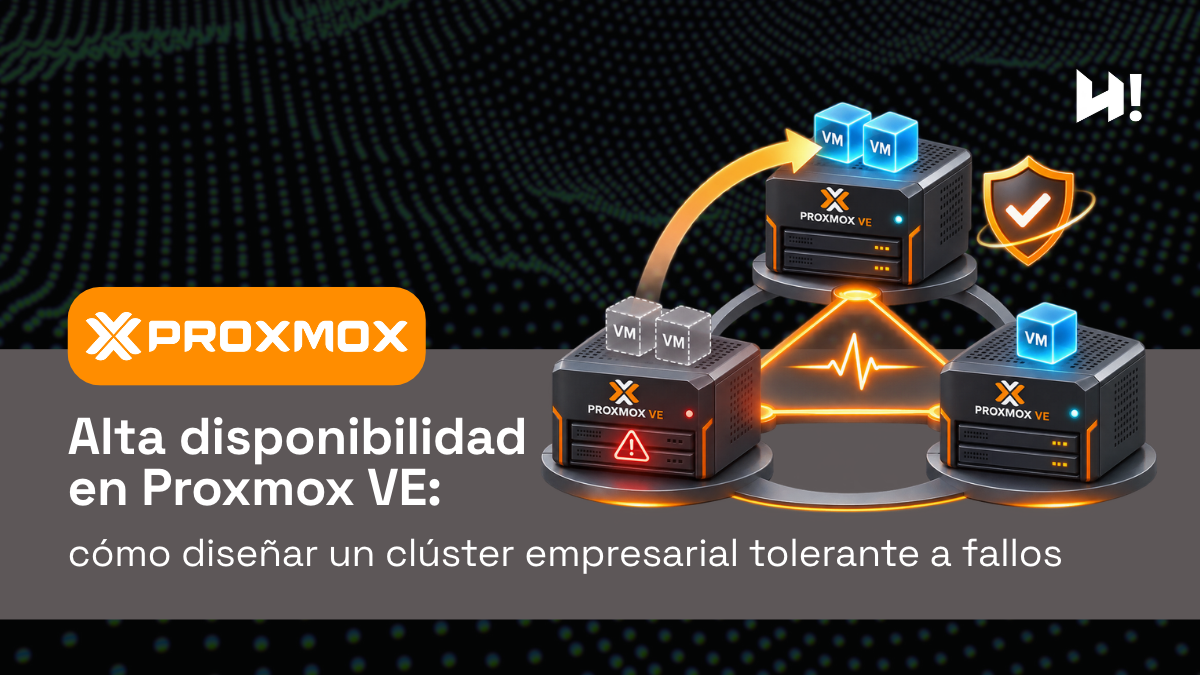
La alta disponibilidad en Proxmox VE no depende únicamente de activar una opción en la plataforma. En un entorno empresarial, requiere diseñar una arquitectura capaz de mantener la continuidad operativa cuando un nodo deja de estar disponible, cuando se produce una incidencia de red o cuando un servicio crítico debe recuperarse en otro punto del clúster.
El objetivo no es eliminar cualquier posible interrupción, sino reducir su impacto mediante decisiones técnicas coherentes: número de nodos, quorum, redundancia de red, almacenamiento, capacidad de reserva, monitorización y procedimientos de recuperación. Para su empresa, este diseño debe responder a una pregunta principal: qué cargas deben seguir funcionando y bajo qué condiciones aceptables de recuperación.
Qué significa alta disponibilidad en Proxmox VE
En Proxmox VE, la alta disponibilidad se plantea sobre un clúster de nodos que comparten una configuración coordinada y permiten gestionar máquinas virtuales o contenedores de forma distribuida. Cuando una carga se integra en la lógica de HA, el entorno puede intentar recuperarla en otro nodo disponible si el nodo de origen falla.
Este enfoque es especialmente relevante para servicios que no pueden depender de un único servidor físico. Sin embargo, la alta disponibilidad no debe confundirse con backup, replicación aislada o tolerancia absoluta a cualquier fallo. La HA ayuda a reducir interrupciones ante determinadas caídas de infraestructura, pero debe formar parte de una estrategia más amplia de continuidad operativa.
Elementos que deben analizarse antes del diseño
- Qué máquinas virtuales o contenedores son realmente críticos para el negocio.
- Qué tiempos de recuperación son aceptables para cada servicio.
- Qué dependencias existen entre aplicaciones, bases de datos, redes y almacenamiento.
- Qué capacidad debe quedar libre para asumir cargas si uno o varios nodos fallan.
- Qué procedimientos operativos se aplicarán durante pruebas, mantenimiento o incidencias.
Clúster y quorum: la base de la consistencia
El clúster es el punto de partida para construir una arquitectura de alta disponibilidad. Su función no es solo agrupar nodos, sino proporcionar una visión común de la configuración y del estado del entorno. Para que esa coordinación sea fiable, el quorum resulta esencial.
El quorum permite que el clúster mantenga una decisión mayoritaria y evite estados inconsistentes cuando hay pérdida de comunicación entre nodos. En términos prácticos, ayuda a prevenir escenarios en los que dos partes del clúster creen tener autoridad al mismo tiempo. Este aspecto es clave para proteger las cargas y evitar decisiones contradictorias ante particiones de red o fallos parciales.
En diseños empresariales, conviene plantear un mínimo de tres nodos para disponer de un quorum más robusto. También es importante revisar cómo se comportará el clúster si se pierde un nodo, si se degrada la red de comunicación o si se produce una desconexión entre sedes o racks.
Riesgos habituales en el diseño del quorum
- Clústeres con pocos nodos y baja tolerancia ante la pérdida de votos.
- Redes de clúster compartidas con tráfico no relacionado o sin aislamiento suficiente.
- Dependencia de un único switch, una única ruta de red o un único dominio eléctrico.
- Falta de pruebas reales sobre pérdida de conectividad, reinicio de nodos o mantenimiento planificado.
Redundancia para evitar puntos únicos de fallo
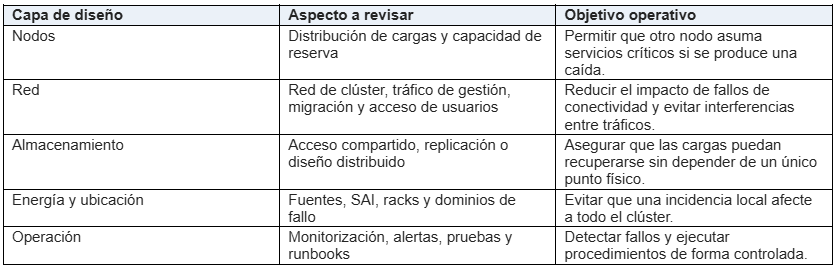
Una arquitectura de HA debe analizar cada componente que puede convertirse en un punto único de fallo. No basta con disponer de varios nodos si todos dependen de la misma ruta de red, del mismo almacenamiento sin redundancia o de una única alimentación eléctrica.
La redundancia debe aplicarse de forma equilibrada. Un exceso de complejidad puede dificultar la operación diaria, pero una arquitectura demasiado simple puede no responder cuando se produce una incidencia. La decisión debe ajustarse a los requisitos de disponibilidad, al presupuesto operativo y a la capacidad del equipo técnico para mantener el entorno.
Capacidad de reserva y tolerancia a fallos
La alta disponibilidad solo es útil si el clúster tiene capacidad suficiente para absorber la caída de un nodo. Por ello, el diseño debe contemplar escenarios de tolerancia a fallos desde el dimensionamiento inicial. Un clúster que funciona al límite de CPU, memoria o almacenamiento puede no ser capaz de reiniciar cargas críticas en otro nodo cuando se produce una incidencia.
En entornos empresariales, es recomendable definir políticas de capacidad con criterios como N+1, distribución de cargas por criticidad y separación de servicios dependientes. Este planteamiento ayuda a evitar que una misma incidencia afecte simultáneamente a todos los componentes de una aplicación crítica.
Buenas prácticas de dimensionamiento
- Reservar capacidad para que las cargas prioritarias puedan arrancar en nodos alternativos.
- Evitar concentrar servicios críticos relacionados en un único nodo físico.
- Revisar periódicamente el crecimiento de consumo de CPU, memoria, red y almacenamiento.
- Definir prioridades de recuperación para no tratar todas las cargas como si tuvieran el mismo impacto de negocio.
- Alinear la arquitectura con los objetivos internos de continuidad y recuperación.
Almacenamiento y recuperación de cargas
El almacenamiento es uno de los puntos más sensibles en un diseño de alta disponibilidad. Si una máquina virtual debe recuperarse en otro nodo, ese nodo debe tener acceso a los datos necesarios. Por tanto, el diseño debe considerar si se utilizará almacenamiento compartido, almacenamiento distribuido o mecanismos de replicación compatibles con los requisitos de recuperación.
La elección no debe realizarse solo por rendimiento o coste. También deben valorarse la consistencia de los datos, la latencia, la facilidad de operación, la escalabilidad y el comportamiento ante fallos. En algunos casos, una configuración válida para cargas no críticas puede ser insuficiente para servicios con requisitos estrictos de continuidad.
Red de clúster, comunicación y aislamiento
La comunicación entre nodos es crítica para que el clúster tome decisiones coherentes. Una red inestable puede provocar falsas detecciones de fallo, pérdida de quorum o comportamientos difíciles de diagnosticar. Por eso, la red de clúster debe diseñarse con especial atención a la latencia, la redundancia y la separación de tráficos.
En un diseño empresarial conviene distinguir, siempre que sea posible, entre tráfico de gestión, tráfico de clúster, tráfico de almacenamiento, tráfico de migración y tráfico de usuarios. Esta separación reduce interferencias y facilita la identificación de problemas cuando se producen incidencias.
Políticas de HA, grupos y prioridades
No todas las cargas requieren el mismo tratamiento. Una arquitectura bien diseñada debe clasificar máquinas virtuales y contenedores según su criticidad, dependencias y objetivos de recuperación. Las políticas de HA deben reflejar esa clasificación, evitando incluir cargas no prioritarias que puedan consumir recursos necesarios durante una recuperación.
Los grupos, las restricciones de ubicación y las prioridades permiten ordenar el comportamiento del clúster. De este modo, su empresa puede definir qué cargas deben recuperarse antes, qué nodos son preferentes y qué servicios no deberían convivir en el mismo dominio de fallo.
Pruebas, monitorización y procedimientos de continuidad
La alta disponibilidad no debe validarse por primera vez durante una incidencia real. Es necesario probar escenarios controlados: caída de un nodo, reinicio planificado, pérdida de conectividad, mantenimiento de almacenamiento o saturación de recursos. Estas pruebas permiten ajustar prioridades, detectar dependencias ocultas y confirmar que el equipo técnico conoce el procedimiento operativo.
La monitorización también debe ir más allá de comprobar si un nodo está encendido. Debe ofrecer visibilidad sobre quorum, estado de servicios HA, consumo de recursos, latencia de red, estado del almacenamiento y eventos relevantes del clúster. Sin esa observabilidad, la recuperación puede depender de diagnósticos manuales en momentos de presión operativa.
Alta disponibilidad como base de continuidad operativa
Diseñar alta disponibilidad en Proxmox VE exige combinar arquitectura, operación y gobierno técnico. El valor no está solo en que una carga pueda reiniciarse en otro nodo, sino en que el clúster mantenga consistencia, disponga de recursos suficientes y responda de forma previsible ante fallos.
Para una empresa, el enfoque adecuado debe partir de la criticidad de los servicios y avanzar hacia un diseño que integre quorum, redundancia, capacidad de reserva, almacenamiento, red, pruebas y procedimientos. Así, Proxmox VE puede formar parte de una estrategia de continuidad operativa más sólida y alineada con las necesidades reales del negocio.
¿Su empresa necesita diseñar un clúster Proxmox VE de alta disponibilidad con un enfoque seguro, escalable y adaptado a sus objetivos de continuidad?
Contacte con el equipo de Hopla!, analicemos juntos el siguiente paso para su infraestructura empresarial.
Preguntas frecuentes
Permite diseñar un clúster capaz de recuperar cargas críticas en nodos alternativos cuando se produce la caída de un nodo, reduciendo el impacto operativo de determinadas incidencias.
El quorum ayuda a mantener decisiones consistentes dentro del clúster y evita estados contradictorios cuando se pierde comunicación entre nodos o se producen fallos parciales.
No. La alta disponibilidad reduce interrupciones ante determinados fallos de infraestructura, mientras que el backup protege frente a pérdida de datos, errores humanos u otros escenarios de recuperación.
Debe revisarse la capacidad disponible, el almacenamiento, la red, las prioridades de recuperación, las dependencias entre servicios y los procedimientos de prueba y operación.