Cuándo una Cadena ya No es Suficiente
LangChain introdujo el paradigma de cadenas (chains) para orquestar flujos de IA: una entrada fluye por una secuencia de pasos y produce una salida. Para flujos lineales simples —pregunta, búsqueda, respuesta— este modelo es perfectamente adecuado. Pero los flujos de negocio reales rara vez son lineales.
¿Qué ocurre cuando el agente necesita tomar una decisión y seguir caminos diferentes según el resultado? Si dos tareas deben ejecutarse en paralelo para reducir la latencia, ¿cómo se coordina su ejecución? También es necesario gestionar bucles en los que el modelo itera hasta cumplir una condición, persistir el estado de una conversación a través de múltiples sesiones de forma robusta e implementar pausas controladas para que un operador humano pueda revisar y aprobar una acción antes de continuar.
Las cadenas no tienen una respuesta nativa y ergonómica para ninguna de estas preguntas. LangGraph sí.
LangGraph es el framework de orquestación con estado del ecosistema LangChain, diseñado específicamente para flujos de IA complejos que requieren control explícito sobre el estado, ejecución condicional, paralelismo, memoria persistente a largo plazo e integración controlada de supervisión humana. No reemplaza a LangChain: lo extiende, usando las mismas abstracciones de LLMs, tools y prompts, pero añadiendo una capa de control del flujo de ejecución fundamentalmente más potente.
StateGraph: El Grafo como Modelo Mental para Flujos Complejos
El concepto central de LangGraph es el StateGraph: un grafo dirigido donde los nodos son funciones de procesamiento (pasos del pipeline) y las aristas son las transiciones entre ellos. El grafo no es solo una metáfora visual: es la estructura de datos real que gestiona la ejecución.
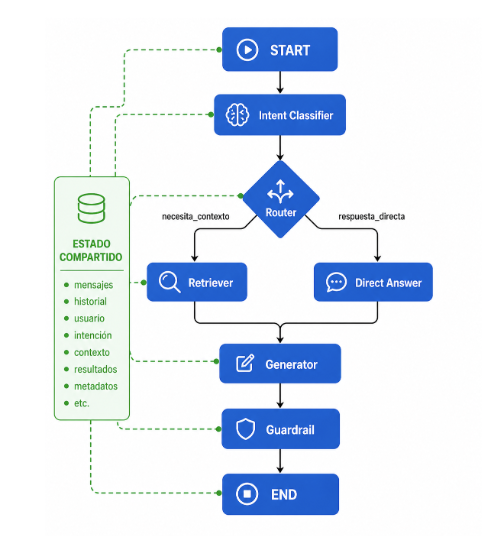
Cada nodo del grafo recibe el estado actual como entrada y devuelve una actualización parcial del estado. El grafo gestiona la propagación de actualizaciones, asegurando que cada nodo vea el estado más reciente pero solo pueda modificar los campos que le corresponden. Este diseño tiene tres consecuencias importantes para entornos enterprise:
Trazabilidad natural. Cada actualización del estado es registrable. Se puede reconstruir el camino exacto de ejecución, qué nodo procesó qué datos, en qué orden, y con qué resultados parciales. Esta trazabilidad es un requisito de compliance en muchos sectores, y LangGraph la proporciona de forma estructural, no como un añadido.
Reproducibilidad. Dado el mismo estado inicial, el mismo grafo produce el mismo resultado. Esto permite reproducir conversaciones para depuración, comparar versiones de agentes de forma controlada, y escribir pruebas deterministas.
Composabilidad. Un grafo puede ser un nodo de otro grafo (sub-grafos). Los pipelines complejos se construyen componiendo grafos más simples, manteniendo la complejidad manejable.
State Schema y Reducers: Control Explícito sobre el Estado
El State Schema de LangGraph define la estructura de datos que fluye por el grafo: qué campos existen, de qué tipo son, y cómo se combinan cuando múltiples nodos los actualizan simultáneamente.
Los reducers son las funciones que determinan cómo se actualizan los campos del estado cuando llegan nuevos valores. El reducer más común para el historial de mensajes es la concatenación: cada nuevo mensaje se añade al final de la lista, nunca reemplaza el historial. Pero los reducers pueden implementar lógica más sofisticada: mantener solo los últimos N elementos, eliminar duplicados, aplicar transformaciones, o implementar lógica personalizada de fusión para ejecuciones paralelas.
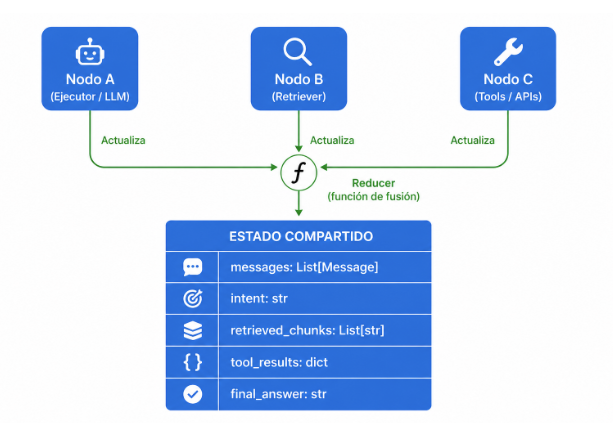
Esta explicitación del contrato de datos es uno de los beneficios menos mencionados de LangGraph pero de los más valiosos en equipos de desarrollo enterprise: hace que el sistema sea legible y predecible para cualquier desarrollador del equipo, independientemente de quién lo construyó originalmente.
Múltiples Schemas: Contratos Explícitos Entre Capas
LangGraph permite definir schemas diferentes para la entrada, la salida y el estado interno del grafo. Esta separación es una buena práctica de ingeniería de software aplicada a la orquestación de IA:
El input schema define exactamente qué espera el grafo como entrada del mundo exterior.
El output schema define exactamente qué devuelve al mundo exterior.
El internal state schema puede contener campos de trabajo que no deben exponerse fuera del grafo.
Esta separación protege la integridad del sistema: el exterior solo ve la interfaz pública definida, y el estado interno puede evolucionar sin romper los consumidores del grafo.
Memoria en LangGraph: Buffer, Resumen, Store y Memoria a Largo Plazo
LangGraph implementa una arquitectura de memoria en múltiples niveles que resuelve el problema completo de la persistencia del contexto en agentes conversacionales de producción.
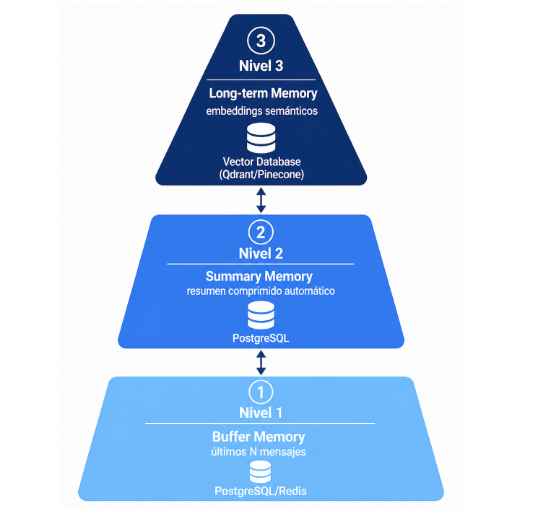
Trim y filter de mensajes. El método más directo: antes de cada llamada al modelo, el pipeline recorta el historial de mensajes a los últimos N o descarta mensajes por encima de un umbral de tokens. Simple, predecible, de coste controlado.
Resumen automático. Cuando la conversación supera un umbral configurable de mensajes, LangGraph puede invocar automáticamente un nodo de summarización que comprime el historial antiguo en un resumen narrativo y lo sustituye en el estado. El modelo recibe el resumen como contexto histórico y los mensajes recientes completos. Esta estrategia combina memoria de larga duración con coste de tokens acotado.
LangGraph Store: Memoria Persistente a Largo Plazo. La funcionalidad más potente. LangGraph Store es un sistema de almacenamiento de namespaces que persiste información entre diferentes conversaciones y sesiones, con soporte nativo para búsqueda semántica. Permite que el agente «recuerde» preferencias de un usuario de conversaciones previas, que aprenda patrones operativos de interacciones pasadas, o que mantenga un perfil de conocimiento acumulado sobre una entidad (cliente, proyecto, incidencia) a lo largo del tiempo.
La arquitectura de memoria de LangGraph representa un punto de inflexión respecto a los chatbots tradicionales: en lugar de reiniciar el contexto en cada sesión, el agente acumula conocimiento operativo de forma persistente, exactamente como lo haría un profesional humano.
Human-in-the-Loop Real: Breakpoints y Control Preciso
El soporte para human-in-the-loop en LangGraph va mucho más allá de lo que ofrecen las chains simples. Los breakpoints son puntos de interrupción definidos explícitamente en el grafo donde la ejecución se suspende, el estado actual se persiste, y el sistema espera input humano antes de continuar.
Un breakpoint puede configurarse antes de cualquier nodo del grafo. El flujo típico es:
- El agente procesa la solicitud y llega al breakpoint configurado.
- El sistema notifica al operador humano con el contexto completo: estado actual, razonamiento del agente, acción propuesta.
- El operador revisa, puede modificar el estado directamente (corregir datos, añadir instrucciones) o simplemente aprobar.
- El grafo reanuda desde el punto exacto de interrupción con el estado actualizado.
Esta capacidad es especialmente valiosa en escenarios enterprise donde la autonomía total no es aceptable: procesos de aprobación con umbrales económicos, comunicaciones externas sensibles, acciones con efectos irreversibles sobre sistemas críticos, o cualquier operación donde el regulador o el equipo legal requiere supervisión humana documentada.
Adicionalmente, LangGraph soporta el patrón de revisión del historial (time travel): dado que el estado de cada paso está persistido, es posible volver al estado de cualquier punto anterior en el grafo, modificar el estado, y re-ejecutar desde ese punto. Esto transforma la corrección de errores: en lugar de reiniciar una conversación compleja, se ajusta el estado en el punto exacto donde algo fue incorrecto.
Streaming: Respuestas en Tiempo Real sin Esperar al Final del Pipeline
En un pipeline de IA sin streaming, el usuario espera a que el sistema complete todo el procesamiento —retrieval, razonamiento, generación— antes de ver la primera palabra de la respuesta. Para pipelines complejos con múltiples herramientas, esto puede significar esperas de varios segundos que degradan severamente la experiencia.
LangGraph soporta streaming en múltiples granularidades:
Token streaming. Los tokens generados por el LLM se transmiten al cliente en tiempo real, exactamente como lo hace ChatGPT. El usuario ve la respuesta construirse carácter a carácter, lo que reduce la percepción de latencia incluso cuando el tiempo total de procesamiento no cambia.
Node-level streaming. Cada vez que un nodo completa su ejecución y actualiza el estado, esa actualización puede transmitirse al cliente. El frontend puede mostrar indicadores de progreso específicos: «Buscando en la base de conocimiento…», «Consultando el CRM…», «Generando respuesta…».
Event streaming. LangGraph emite eventos tipados para cada cambio de estado, tool call, inicio/fin de nodo, y token generado. El cliente puede suscribirse selectivamente a los eventos que le interesan.
Esta capacidad de streaming no es cosmética: en sistemas donde los usuarios interactúan repetidamente con el agente, la diferencia entre una respuesta progresiva y una espera bloqueante impacta directamente en las tasas de adopción y satisfacción.
Paralelización de Nodos: Ejecución Simultánea de Tareas Independientes
Cuando dos nodos del grafo no tienen dependencia entre sí, LangGraph puede ejecutarlos en paralelo de forma nativa. Esta capacidad tiene un impacto directo y medible en la latencia total del pipeline.
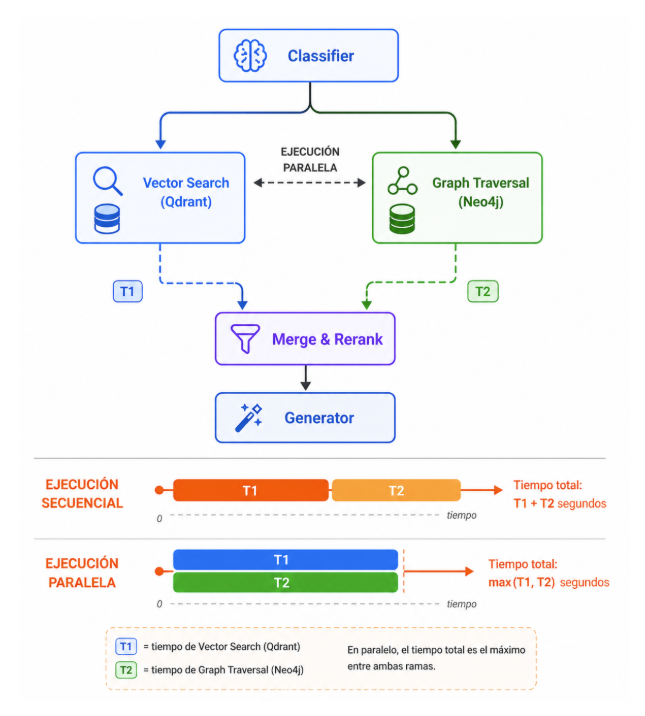
Consideremos un agente que necesita, para cada consulta, buscar en una base de conocimiento vectorial (búsqueda semántica) y en un grafo de conocimiento (traversal de entidades). Secuencialmente, si cada búsqueda tarda 400ms, el total es 800ms. En paralelo, ambas se ejecutan simultáneamente y el total es 400ms. Para sistemas con altos volúmenes de consultas, esta reducción de latencia tiene impacto directo en los costes de infraestructura y en la experiencia del usuario.
La paralelización en LangGraph se configura declarativamente: se definen las ramas paralelas en el grafo, se especifica el nodo de convergencia donde los resultados se fusionan, y el framework gestiona la sincronización automáticamente sin que el desarrollador deba implementar lógica de hilos o callbacks.
Sub-Grafos: Composición de Pipelines Complejos
Un sub-grafo es un StateGraph completo que se usa como nodo dentro de otro grafo. Esta capacidad de composición es fundamental para gestionar la complejidad en sistemas de IA enterprise de gran escala.
Los sub-grafos permiten una división clara de responsabilidades: el equipo de retrieval desarrolla y mantiene de forma independiente el sub-grafo de recuperación de conocimiento. El equipo de integración desarrolla el sub-grafo de herramientas CRM. El equipo de producto ensambla estos sub-grafos en el grafo principal del agente sin necesidad de conocer los detalles internos de cada componente.
Esta modularidad también facilita el testing: cada sub-grafo puede probarse de forma completamente independiente con entradas y estados sintéticos, sin necesidad de levantar el pipeline completo.
Map-Reduce: Procesamiento Escalable de Colecciones
El patrón map-reduce en LangGraph permite procesar colecciones de elementos de forma paralela y consolidar los resultados. La rama map genera dinámicamente N nodos paralelos (uno por elemento de la colección), y la rama reduce espera a que todos completen y fusiona los resultados.
Este patrón es especialmente relevante en escenarios enterprise como:
- Análisis de un conjunto de documentos: cada documento se analiza en paralelo; el reduce consolida los hallazgos en un informe unificado.
- Procesamiento de un backlog de incidencias: cada ticket se clasifica y prioriza independientemente; el reduce genera el informe de priorización global.
- Validación multiagente de una decisión: múltiples agentes especializados evalúan una propuesta desde sus perspectivas; el reduce sintetiza las evaluaciones en una recomendación final.
- Búsqueda multi-query: el agente genera N variantes de la consulta del usuario, las ejecuta en paralelo y el reduce deduplica y ranquea los resultados combinados.
Casos de Uso donde LangGraph Brilla en Entornos Enterprise
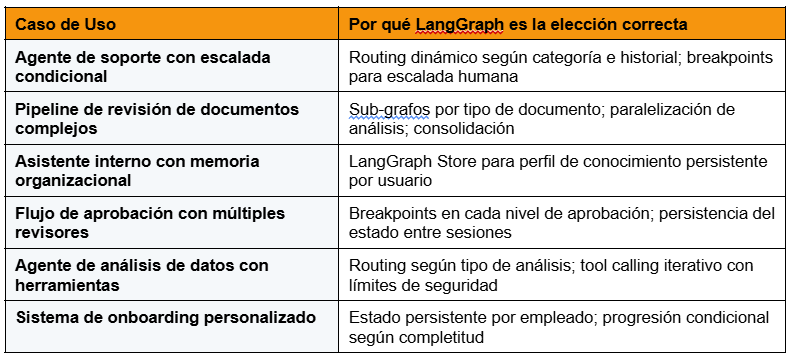
El estado como ventaja arquitectónica
LangGraph representa una madurez arquitectónica en el desarrollo de sistemas de IA que los frameworks de chains simples no pueden igualar. La gestión explícita del estado, la memoria persistente en múltiples niveles, el control preciso del flujo de ejecución y el soporte nativo para supervisión humana no son características de conveniencia: son los cimientos que hacen posible construir agentes de IA que se comportan de forma predecible, auditable y mantenible en entornos de producción exigentes.
Para equipos enterprise que están pasando de prototipos a sistemas de IA en producción real, LangGraph es la herramienta que marca la diferencia entre un demo impresionante y un producto de software robusto.
En Hopla hemos implementado pipelines LangGraph en producción para casos de uso enterprise con requisitos de alta disponibilidad, compliance regulatorio y volúmenes de miles de conversaciones mensuales.
¿Su empresa está valorando LangGraph para desarrollar agentes de IA con estado, memoria persistente y supervisión humana?
Contacte con nuestro equipo para evaluar los requisitos de su proyecto y definir una arquitectura adecuada.
Preguntas Frecuentes
No, son complementarios. LangGraph extiende LangChain añadiendo gestión de estado, grafos condicionales y memoria persistente. Todos los componentes de LangChain (LLMs, tools, prompts, memory) funcionan directamente dentro de LangGraph. La elección no es «uno u otro» sino qué capa de control de flujo necesita el problema específico.
Un desarrollador con experiencia sólida en LangChain puede construir su primer grafo funcional en LangGraph en uno o dos días. El concepto de StateGraph, nodos y reducers es intuitivo. Los patrones avanzados (sub-grafos, streaming completo, LangGraph Store) requieren una inversión adicional de una o dos semanas para dominarlos con solidez.
LangSmith proporciona una visualización interactiva del grafo de ejecución: se puede ver el flujo exacto que tomó cada conversación, el estado en cada nodo, los tokens consumidos por cada LLM y las herramientas invocadas. Para errores en producción, el sistema de persistencia de estado permite reproducir exactamente el contexto que produjo el error.
Sí. LangGraph es stateless por diseño: el estado se persiste en la base de datos configurada (PostgreSQL, Redis, etc.), no en memoria del proceso. Esto permite escalar horizontalmente los workers sin afinidad de sesión y recuperarse de fallos sin pérdida de contexto conversacional.
LangGraph soporta checkpointers para PostgreSQL, SQLite, Redis y MongoDB de forma nativa, con una interfaz extensible para implementar backends personalizados. En entornos enterprise, PostgreSQL es la elección estándar por su robustez transaccional y las garantías ACID sobre el estado persistido.
LangGraph soporta lógica de reintento configurable por nodo, con políticas de backoff exponencial. Dado que el estado se persiste en checkpoints, un fallo en el nodo N no implica reiniciar el pipeline desde el inicio: la ejecución puede reanudarse desde el último checkpoint exitoso.